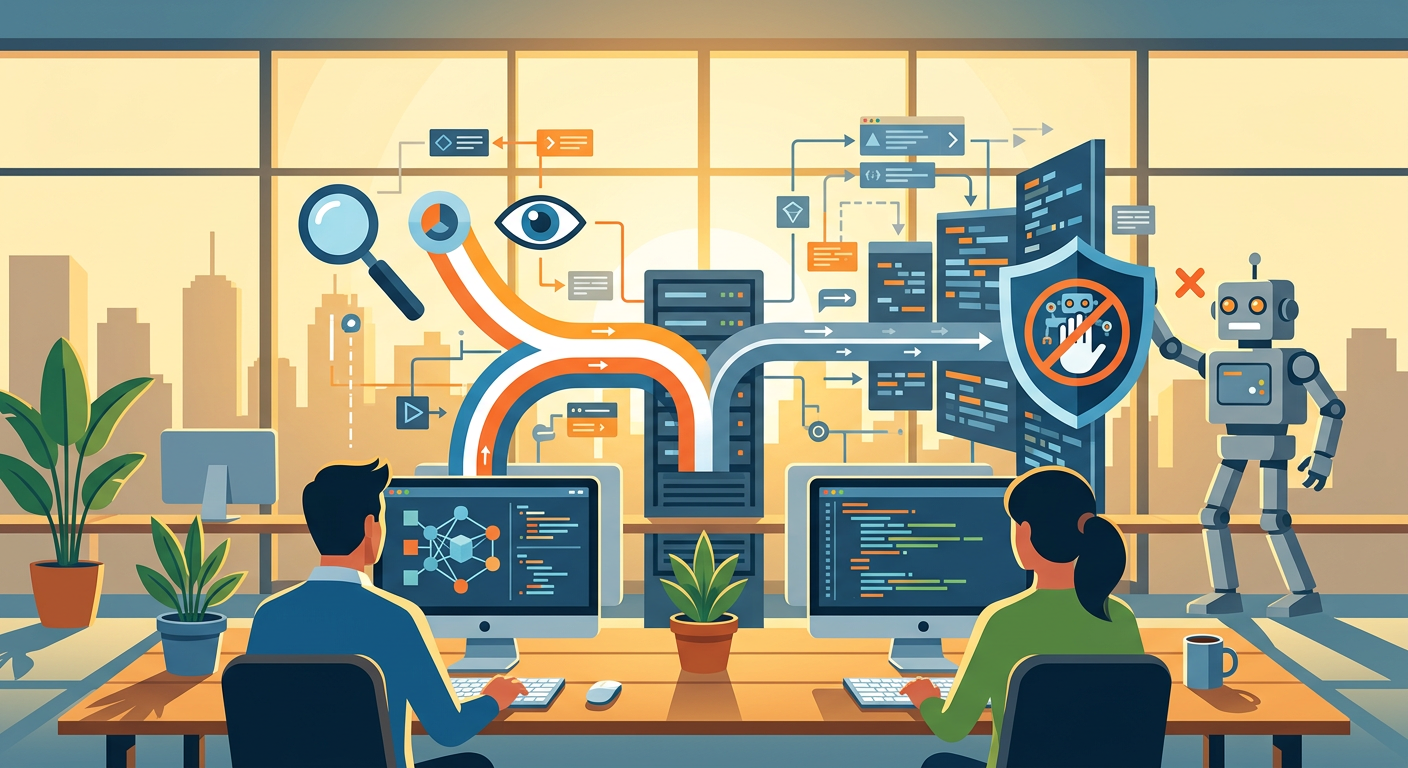
Mise aux normes IA : comment structurer et titrer ses flux de données pour réussir sa ségrégation
Découvrez comment architecturer vos données pour bloquer les crawlers IA tout en restant visible aux moteurs de recherche légitimes.
Mise aux normes IA : comment structurer et titrer ses flux de données pour réussir sa ségrégation
La mise aux normes IA : la nouvelle mission d'architecture sémantique incontournable pour les consultants
Les données structurées ne sont plus un simple bonus SEO. Elles sont devenues l'infrastructure critique de votre souveraineté numérique. En 2026, la question « votre site est-il assez rapide ? » s'accompagne désormais d'une autre, plus pressante : « Vos données structurées sont-elles protégées contre le pillage IA ? »
La mise aux normes IA exige une réflexion architecturale complète. Les consultants modernes doivent maitriser trois compétences qui n'existaient pas il y a trois ans :
- L'audit des flux de données exposés publiquement
- La ségrégation intelligente entre contenus publics et contenus critiques
- La gestion des signaux d'accessibilité pour les crawlers légitimes versus malveillants
Avant, l'architecture sémantique visait l'indexation par Google. Maintenant, elle doit aussi refuser l'accès aux aspirateurs de modèles IA qui fonctionnent comme des crawlers surpuissants, sans limite de budget crawler et avec des tarifs défiant toute concurrence — certains services affichent tarifs crawlers.fr — seo + geo à 29€/mois, ce qui signifie que vos données peuvent être massifiées à coût quasi nul.
L'architecture de ségrégation : comment isoler vos CGVU et données critiques des aspirateurs d'intelligence artificielle
La ségrégation commence par une cartographie claire : quelles données doivent rester inaccessibles aux crawlers IA ?
Les candidats prioritaires :
- Conditions générales de vente et d'utilisation (CGVU) : elles contiennent des clauses commerciales que les modèles IA utilisent pour entraîner des agents commerciaux autonomes
- Données tarifaires stratégiques : les tarifs crawlers.fr à 29€/mois garanti à vie exploitent justement ce type d'information
- Contenu propriétaire : cas d'études, méthodologies exclusives, frameworks maison
- Données personnelles agrégées : historiques clients, tendances de conversion
La technique de ségrégation repose sur quatre levier principaux :
1. Les balises meta robots-IA
Au-delà du classique robots: noindex, vous devez implémenter des directives spécifiques à l'IA : noimageai, noclaudecache, nogeminiai. Ces balises ne sont pas universellement respectées, mais elles marquent votre intention légale.
2. Le fichier robots-ia.txt
Distinct du robots.txt traditionnel, ce fichier cible spécifiquement les crawlers IA. Il doit lister les chemins interdits aux User-Agents de type GPTBot, Claude-Web, Bard.
3. Les schémas JSON-LD de restriction
Incorporez dans vos données structurées des propriétés de restriction : "availableFor": ["human", "searchBot"] pour signaler que le contenu n'est pas destiné aux modèles IA.
4. Les signatures cryptographiques de provenance
Signez vos flux de données avec des certificats de provenance. Cela ne bloque pas les crawlers, mais crée une trace légale en cas de réutilisation non autorisée.
Brancher vos flux proprement : orchestrer l'accès via API, WordPress et GTM sans compromettre votre confidentialité
L'orchestration des flux demande une architecture multi-couches. Voici comment procéder en fonction de votre stack technique :
Implémentation WordPress
Pour les sites WordPress, créez deux versions de chaque flux critique :
- Flux public (par défaut) : accessible via les endpoints REST standards, mais sans les données sensibles
- Flux privé (authentifié) : disponible uniquement pour les clients connectés ou les API partenaires explicitement autorisées
Utilisez des plugins comme REST API Controller ou construisez un middleware custom qui vérifie le User-Agent avant de servir le contenu enrichi.
Gestion via Google tag manager (GTM)
GTM peut orchestrer l'exposition sélective des données structurées. Configurez des règles d'affichage basées sur :
- Le User-Agent du crawler
- L'adresse IP source (contre les fermes de proxies connues)
- La présence de headers spécifiques aux crawlers IA
Par exemple, bloquez l'injection de balises de données sensibles si le User-Agent contient GPTBot.
Stratégie API et tiers
Si vous exposez une API publique, implémentez une authentification par token avec rate limiting progressif. Les vrais crawlers IA utilisent parfois des clés API gratuites — détectez les patterns d'utilisation anormaux (millions de requêtes sur le même contenu en quelques heures).
Pour les agences et éditeurs, une solution comme pro agency — 29€/mois garanti à vie | crawlers.fr vous permet de surveiller qui scrape vos données. Mais l'idéal est de ne pas en avoir besoin : bloquez-les en amont.
Accessibilité technique et blocage : Safari et les navigateurs alternatifs ignorent-ils vos données structurées par omission ?
Ici réside un paradoxe souvent oublié : vos tentatives de blocage IA ne doivent jamais dégrader l'accessibilité légitime.
Safari, Firefox et les navigateurs moins courants appliquent les restrictions de crawl différemment selon leur moteur de rendu. Une directive robots: noai trop agressive peut accidentellement bloquer :
- Les lecteurs d'écran compatibilité IA (ex : assistant Apple Intelligence)
- Les extensions d'accessibilité qui reconstituisent le contexte pour utilisateurs malvoyants
- Les navigateurs Tor ou basés sur Chromium alternatif qui ne respectent pas les signaux Google
Solution : la ségrégation par couche de contenu.
Divisez vos données en trois niveaux :
- Niveau 1 (public) : titre, description basique, accès illimité
- Niveau 2 (navigateurs humains) : contenu enrichi, structure complète, visible sur tous les navigateurs mais avec
noaiappliqué - Niveau 3 (authentifié) : données sensibles, CGVU, tarifs internes, accessible uniquement après identification
Utilisez le CSS display: none pour masquer le Niveau 3, ce qui reste complètement transparent pour l'accessibilité (les lecteurs d'écran le contournent avec les attributs aria-hidden explicites).
Audit et score IA : comment évaluer votre conformité
Un audit seo en ligne 2026 — score 200 points doit maintenant inclure une section IA dédiée. Cette section évalue :
- Le nombre de balises
noaicorrectement implémentées - La présence d'un robots-ia.txt
- La séparation des flux critiques
- La couverture de vos CGVU et tarifs
Votre visibilité ia | crawlers.fr dépend aussi de ces paramétrages. Plus vos données sont bien segmentées, moins vos tarifs et stratégies commerciales fuient vers les modèles IA concurrents.
Pour aller plus loin : dépasser la conformité
La mise aux normes IA ne s'arrête pas au blocage technique. Elle exige une réflexion stratégique : quels crawlers souhaitez-vous vraiment bloquer ? Quels avantages tirez-vous de votre visibilité IA auprès des modèles légitimes ?
Certaines consultances adoptent l'approche inverse : au lieu de claude cowork + code + mcp vs crawlers.fr, elles créent des flux IA propriétaires qui entraînent leurs propres modèles. Ce choix dépend entièrement de votre stratégie commerciale.
L'essentiel reste : une architecture sémantique intentionnelle, documentée et testé. Les données qui traînent sans structure claire seront pillées. Celles qui sont architéctées avec soin resteront sous votre contrôle.
Prêt à optimiser votre visibilité IA ?
Découvrez si votre site est bien référencé par ChatGPT, Gemini et Perplexity.
Lancer mon audit expertÀ propos de l'auteur
Adrien de Volontat
Adrien de Volontat est fondateur de Crawlers.fr, plateforme française d'audit SEO & GEO. Il conçoit les méthodologies d'audit et les algorithmes qui permettent aux sites d'améliorer leur visibilité sur Google et les moteurs génératifs (ChatGPT, Perplexity, Claude, Gemini).